
 BytePlus
Seedream 5.0 Flash 是字节研发的一款兼顾速度与成本效率的快速图像创作模型,支持精准编辑、图层拆分、透明背景图输出,适合高频、规模化图片生产和快速交互场景。
汇聚全球顶尖模型,一站式接入 OpenAI、Anthropic、Google 等主流提供商。
 BytePlus
Seedream 5.0 Flash 是字节研发的一款兼顾速度与成本效率的快速图像创作模型,支持精准编辑、图层拆分、透明背景图输出,适合高频、规模化图片生产和快速交互场景。
 Google
Nano Banana 2.1 是谷歌最新的高效图像生成与对话式编辑模型,基于 Gemini 3.6 Flash,是 Nano Banana 2 的升级版本。它在保持 Flash 级速度的同时,提升了 1K、2K、4K 下的画质、提示词遵循、文字渲染、蒙版编辑与多轮角色一致性,并可融合最多 14 张参考图。
BytePlusSeedream 5.0 Pro 是 ByteDance 推出的一款多模态图像模型,专为可控生成、精准编辑、复杂信息可视化、逼真人像以及多语言视觉创作而打造。
 Anthropic
Claude Sonnet 5.5 是 Anthropic 升级版的 Sonnet 级模型,性能强于 Claude Sonnet 5,同时运行速度提升超过 30%,且在许多工作负载下成本更低。它专为代理式编码、工具使用和日常专业任务而设计,非常适合开发人员和团队构建快速且功能强大的 AI 智能体。
 Anthropic
Claude Opus 5.5 是 Anthropic 旗下的旗舰模型,专为高要求的推理、编码和长周期智能体任务而设计,是 Claude Opus 5 的继任者。它在处理大型代码库的多步骤变更、代码审查与缺陷查找、金融与科学分析,以及解读密集型图表、示意图和截图方面表现尤为出色。与前代产品相比,它在引用数据和来源时更加严谨,确保仅陈述可证实的内容。
 DeepSeek
 V4.1 Flash 也称 DeepSeek Flash,是 DeepSeek 的一款拥有 552B 参数的 MoE 模型,构建于全新的因果编码器-解码器架构之上,旨在实现更强的能力、更快的推理、更高的吞吐量以及更低的部署成本。它原生支持多模态视觉理解,并提供旗舰级的智能水平,同时显著降低了 KV 缓存需求,非常适合高吞吐量和成本敏感的智能体工作负载。
 Google
Gemini Omni Flash 1.1 是 Google 面向高并发场景的轻量视频生成与编辑预览模型。它把文本、图片与视频转化为带原生同步音频的短片,支持首尾帧插值与场景续写,从 360p 快速草稿一路覆盖到 4K 成片。
 OpenAI
GPT Image 2.5 是 OpenAI 推出的高级图像生成与编辑模型,旨在实现更清晰的画面质量、更高的参考图还原度以及更精细的图像优化。该模型能生成更自然的光影与纹理,更好地稳定保留主体特征,并且在多次编辑场景下,能够更精准地执行复杂的视觉指令。
 OpenAI
GPT-6 Astra 是 OpenAI 目前处理复杂推理、编码、计算机使用、研究和文档创建能力最强的模型,在跨代码、浏览器和专业软件的多步骤工作流程中表现优异。它支持 low、medium、high、xhigh 和 max 等不同程度的 reasoning.effort,能够在实现出色结果的同时,通过减少输出 token 的使用,从而降低单项任务的预估成本。此外,它也是 OpenAI 迄今为止对齐度最高的模型,旨在精准遵循指令、遵守任务边界、适应不断变化的需求并实现透明沟通。
 Google
Gemini 3.8 Flash 是 Google 迄今为止最智能的主力模型,在软件工程、代理工作流以及针对专业领域的逐步推理方面,相较于 3.7 Flash 实现了重大提升。它在接近高成本前沿模型质量的同时,仍提供可配置的性能水平,以平衡性能与 Token 效率。

 fal.ai
MiniMax H3 Max是MiniMax H3基于fal进行后训练的衍生版本,经过调优以实现更强的提示词遵循能力与更佳画面质感。该模型具备极快的运行速度,通过推理生成一段视频通常仅需数秒。
 Alibaba
Wan3.0-Video-Prime 是万相3.0 的高速版视频生成模型,能力对齐 Wan3.0-Video 标准版,支持四模态全能参考,最长可生成30秒视频,带来沉浸式视听体验的同时端到端速度显著提升。
 BytePlus
Seedance 2.5 特价版,满血,附带素材库,自动过审,真人通过率100%,长期运行稳定。 售价约为官方定价的60%,支持720P分辨率。
BytePlusSeedance 2.0 Mini 预算版模型,满血版本,附带素材库,自动审核,真人通过率100%,长期运行稳定。 价格约为官方定价的60%,支持720P分辨率。
BytePlusSeedance 2.0 Fast 特价版模型,满血版,有素材库,不崩脸,百分之百过真人,长期稳定。 价格约为官方 6 折左右,支持 720P。
 BytePlus
Seedance 2.5 是字节跳动的新一代AI视频模型,支持最长30秒视频生成、高级多模态参考控制、精准局部编辑,以及更灵活、可投入实际生产的创意工作流。
 BytePlus
Seedance 2.0 特价版模型,满血版,有素材库,不崩脸,百分之百过真人,长期稳定。 价格约为官方 6 折左右,支持 720P。
 BytePlus
Seedance 2.0 Mini 版模型成本约为标准版一半,速度比 Fast 再快 2 倍,480P/720P 输出,适合批量与规模化生产。当前版本是满血版本的 Seedance 2.0 Mini 模型,支持真人、人脸。 $官方原价格基于 Token 计费,单位:$/百万tokens: 包含视频输入 2.1 $ 不含视频输入:3.5 $ 现在限时优惠 4 折!
 BytePlus
Seedance 2.0 Fast 模型与标准版同任务体系,480P/720P 输出,出片更快、单价更低,适合草稿迭代与高并发预览。当前版本是满血版本的 Seedance 2.0 Fast 模型,支持真人、人脸。 $官方原价格基于 Token 计费,单位:$/百万tokens: 包含视频输入 3.3 $ 不含视频输入:5.6 $ 现在限时优惠 7.5 折!
 xAI
xAI: Grok 4.6 由 xAI 于 2026 年 8 月 13 日发布,在 Grok 4.5 的基础上进行了升级,重点强化了长期运行的多步骤智能体任务和交互式视觉项目创建能力。其在综合智能指数上与 GPT-5.6 Sol 持平,并擅长将广泛的产品构想快速转化为结构化、交互式且可运行的应用程序初版。
 DeepSeek
 V4 Pro 是 DeepSeek 的旗舰级开源混合专家(MoE)模型,总参1.6T、激活 49B,原生支持百万级超长上下文。依托海量高质量训练数据,具备顶尖数学逻辑、复杂推理、专业代码与长文本深度解析能力,适配高阶科研、复杂办公、深度智能代理等高难度场景。
 DeepSeek
‑V4‑Flash 是DeepSeek V4 系列面向效率优化的变体版本,该模型面向有如下需求的开发者:希望以速度更快、成本更低的API服务,获取V4系列的长上下文与推理能力。相较于V4‑Pro,V4‑Flash的总参数量与激活参数量更小,因此响应速度更快,API调用成本也更低。其推理能力接近V4‑Pro,在简单智能体任务上可与V4‑Pro持平,仅在要求最高的智能体工作流场景下才会出现可观测的性能差距。其世界知识储备略逊于V4‑Pro,但在开源模型中依旧具备较强竞争力。
 Alibaba
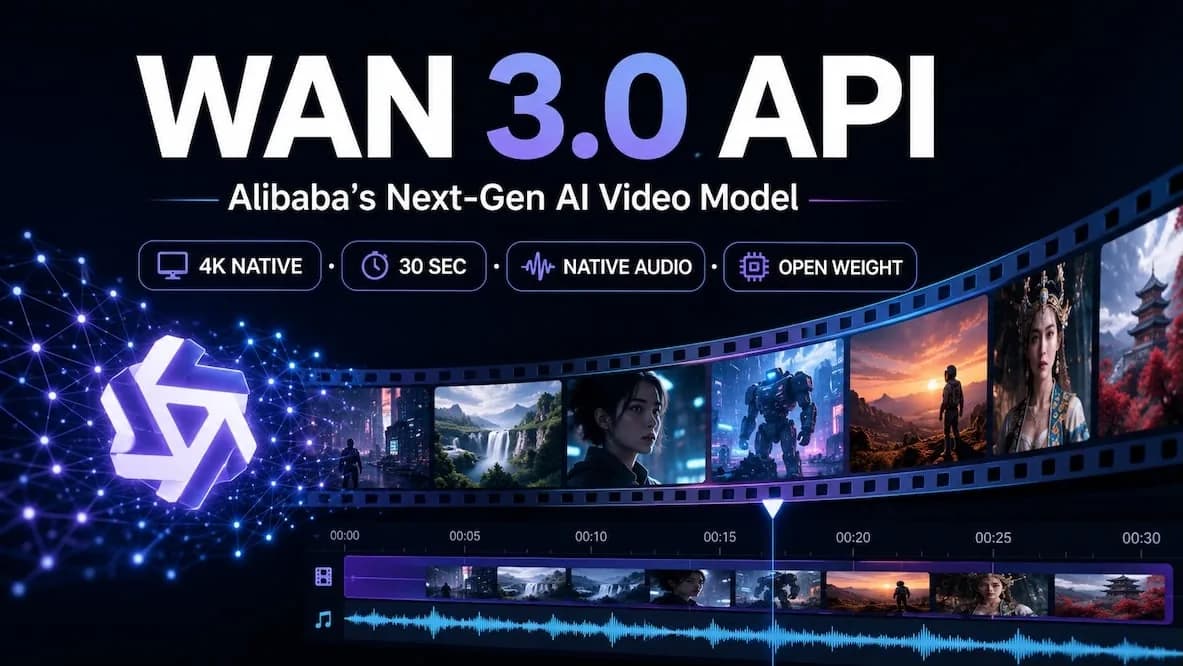
万相3.0是全能参考视频生成模型(All-in-One),统一支持文生视频、图生视频(首帧/首尾帧)和参考生视频等多种用法。最长可生成30秒视频。
 MiniMax
 H3,开源模型,融合文本、图像、视频与音频能力,支持2K视频生成、多模态参考、原生立体声、动作迁移以及精准编辑。
 Google
Gemini 3.6 Flash 是谷歌推出的高效模型,适用于代码编写、智能代理工作流以及网页与应用开发。该模型旨在生成完善的输出内容,减少多余修改与模棱两可的表述,同时降低令牌消耗量,减少完成任务所需调用模型的次数。
 Anthropic
Claude Opus 5 是 Anthropic 旗舰级 Opus 系列模型,专为高级推理、编码和高价值知识工作而设计,提供接近 Claude Fable 5 的前沿级性能,成本约为后者的一半。它支持文本、图像和文件输入以及文本输出,提供 100 万 token 的上下文窗口,非常适合复杂的软件工程、科学研究和长期代理工作流。
 Kimi
Kimi K3 是 Kimi 迄今为止性能最强的模型,拥有2.8万亿参数。该模型基于混合线性注意力机制Kimi Delta Attention与注意力残差结构搭建,原生支持视觉理解,并具备百万词元上下文窗口,可适配软件工程、知识工作、深度推理等前沿智能应用场景。
 Z.AI
GLM-5.2 支持更大的上下文窗口与输出长度,上下文容量最高可达100万令牌,输出令牌上限为12.8万。该模型同时具备更出色的代码编写能力与更先进的推理能力。
 xAI
Grok 4.5 是 SpaceXAI 推出的前沿模型,专为代码编写、智能自主任务与知识类工作打造。该模型在 SpaceXAI 位于孟菲斯的数据中心完成训练,训练所用全新数据集涵盖科学、工程与数学领域。
 OpenAI
GPT-5.6 Luna 是 OpenAI GPT-5.6 系列中一款运行速度快、性价比高的模型。它适用于对话、文本分类、轻量智能体工作流等高并发、低延迟需求场景,在同价位模型中具备出色的推理能力。
 OpenAI
GPT-5.6 Terra 是性能强劲的 GPT-5.6 系列模型,专为长上下文、可调用工具的工作流打造,适用于文案撰写、代码编写、数据分析以及多步骤问题求解场景。该模型支持文本、图片与文件输入,输出形式为文本,同时经过优化,具备出色的指令遵循能力、稳定的推理能力,可精准完成各类复杂任务。
 OpenAI
GPT-5.5 是 OpenAI 推出的前沿模型,面向复杂专业工作场景打造。该模型在 GPT-5.4 的基础上进一步提升推理能力与运行稳定性,并针对高难度任务优化了令牌使用效率。它拥有超百万令牌的上下文窗口,支持文本与图像双输入,可在单一系统内完成大规模逻辑推理、代码编写以及多模态工作流程处理。
 OpenAI
GPT-5.6 Sol 是 GPT-5.6 系列中的前沿模型,大致等同于早期GPT-5系列里无后缀版本的模型层级。
 Anthropic
Claude Sonnet 5 是迄今为止自主性最强的Sonnet系列模型。它能够制定规划、调用浏览器、终端等工具,并实现自主运行,其能力水准在此前仅能依靠规模更大、成本更高的模型才能达成。
 Anthropic
Claude Opus 4.8 是Anthropic旗下Opus系列中综合能力最强的正式商用模型。该模型支持文本、图片与文件输入,输出形式为文本,具备推理能力,上下文窗口容量达100万令牌。它适用于高度自主智能体、长周期智能任务、知识类工作以及依赖记忆的任务,这类任务对长时间会话内内容逻辑连贯度有较高要求。
 Anthropic
Claude Fable 5 是Anthropic推出的 Mythos 级大模型,专为自主知识处理与代码开发打造。该模型支持文本、图像、文件三类输入,输出形式为文本,具备推理能力,上下文窗口容量达100万令牌。对于以往需要人工频繁监督的长期、复杂、异步任务,此模型表现尤为出色。 它的核心优势在于能够处理原本需要人工耗费数小时、数天甚至数周才能完成的全流程工作,可解决周期长、界定模糊、包含大量相互关联步骤的复杂问题。该模型执行明确规范的任务时误差极低,可通过内置校验闭环实现自我纠错,同时具备完善的安全防护机制。
 xAI
Grok Imagine 1.5 是 xAI 最新的图生视频模型,可将单张或多张静态图片转化为流畅且富有电影质感的视频。
 Google
 Gemini Omni 是一款多模态视频生成与编辑模型,可将文本、图像和视频参考转化为连贯视频,并提供稳定场景一致性、世界理解能力和自然语言控制。
 Google
Gemini 3.5 Flash 专为支持高速、高性价比且复杂的开发者和智能体工作流程而设计。它将强大的多步推理能力引入高度优化、低延迟的框架中,使其在大规模运行海量推理循环时非常高效。
 OpenAI
GPT Image 2 是 OpenAI 的新一代图像模型,具备更强的逼真度、更精细的图像编辑能力、更清晰的文本渲染以及更出色的产品效果图表现。它专为更高阶的视觉工作流打造,不仅突破了基础文生图的局限,更能全面满足高质量的创意、商业及专业设计级应用需求。
 Anthropic
Claude Opus 4.7 能够严谨且稳定地处理复杂、耗时较长的任务,精准遵循指令要求,并在反馈结果前设计方法对自身输出内容进行核验。
 Alibaba
Wan 2.7 视频模型将文本、图像及参考驱动的视频生成与原生同步音频实现一次性统一生成,能够呈现更清晰的细节、更流畅的影视级动态效果以及更连贯的镜头语言,可规模化产出适用于专业制作的叙事内容。
 Alibaba
WAN 2.7 Image 是一套可投入生产环境使用的AI图像生成与图像编辑大模型,具备内置思维模式,可提升推理能力并生成更高质量的输出结果。
 OpenAI
GPT-5.4 nano 专为对速度与成本要求最高的任务而设计,例如分类、数据提取、排序以及子智能体等任务。
OpenAIGPT-5.4 mini 是基于 GPT-5.4 的一款更快速、更高效的模型中,专为高负载工作场景设计。
 Google
 最具成本效益的多模态模型,可为高频轻量级任务提供最快的性能。Gemini 3.1 Flash-Lite 最适合处理海量代理任务、简单的数据提取任务,以及预算和速度是主要限制因素的极低延迟应用。
GoogleGemini 3.1 Pro Preview 是谷歌的前沿推理模型,在复杂工作流中能提升软件工程性能、增强智能体可靠性,并更高效地使用令牌。
 Anthropic
Claude Opus 4.6 是为能在整个工作流程而非单一提示下运行的代理程序打造的,因此在大型代码库、复杂重构以及随时间展开的多步骤调试方面尤为高效。与前几代模型相比,该模型在较难的工程任务上展现出更深入的语境理解、更强的问题分解能力和更高的可靠性。 除了编码,Claude Opus 4.6 在持续的知识型工作中也表现出色。它能一次性生成接近可投入生产的文档、计划和分析,并且在极长的输出内容和长时间的会话中保持连贯性。这使其成为需要持久性、判断力和执行力的任务(如技术设计、迁移规划和端到端项目执行)的理想之选。

 KLING
Kling Motion Control 是快手可灵团队推出的一款 AI 视频动作模型。
 xAI
Grok Imagine 是 xAI 发布的一款多模态视频模型,能够根据文本或图像生成图像和短视频。它具有生成速度快、音视频同步的特点,能呈现更具表现力的视觉风格。
OpenAIGPT-5.4 Pro 是 OpenAI 最先进的模型,它在 GPT-5.4 统一架构的基础上构建,具备更强的推理能力,可应对复杂、高风险的任务。该模型拥有超过 100万 token 的上下文窗口(92.2万输入,12.8万输出),支持文本和图像输入。GPT-5.4 Pro 针对逐步推理、指令遵循和准确性进行了优化,在智能体编码、长上下文工作流以及多步骤问题解决方面表现出色。
 OpenAI
GPT-5.4 是 OpenAI 最新推出的前沿大模型,它将 Codex 系列与 GPT 系列整合为统一系统。该模型拥有超 100 万词元的上下文窗口(92.2 万输入 Token、12.8 万输出 Token),支持文本与图像输入,可在同一工作流中完成高上下文推理、代码编写及多模态分析。 该模型在代码编写、文档理解、工具调用与指令执行方面的性能均有提升。它既适用于通用任务,也面向软件工程场景,可生成生产级代码、整合多源信息,还能以更少的迭代次数与更高的词元效率执行复杂的多步骤工作流。
 BytePlus
Seedance 2.0 是字节跳动推出的新一代 AI 视频生成模型,主打高质量、长时长视频创作。当前版本是满血版本的 Seedance 2.0 模型,支持真人、人脸。 核心亮点: • 流畅动作 复杂人物动作、镜头运动自然流畅 • 精准控制 支持文本、图像、姿态引导 • 快速生成 优化推理,生成效率大幅提升 相比前代,Seedance 2.0 在画面质量、动作连贯性、语义理解上全面进化,适合创作者快速产出专业级视频内容。 $官方原价格基于 Token 计费: 480P/720P:原价是:包含视频输入 4.3 $/mTokens,不含视频输入:7 $/mTokens 1080P:原价是:包含视频输入 4.7 $/mTokens,不含视频输入:7.7 $/mTokens 4K:原价是:包含视频输入 2.4 $/mTokens,不含视频输入:5 $/mTokens 无条件折扣价:9 折,需要更大折扣可以联系我们!
 Anthropic
Claude Sonnet 4.6 擅长迭代开发、复杂代码库导航、具备记忆功能的端到端项目管理、精致文档创建,以及在网络质量保证和工作流自动化方面熟练使用计算机。
 BytePlus
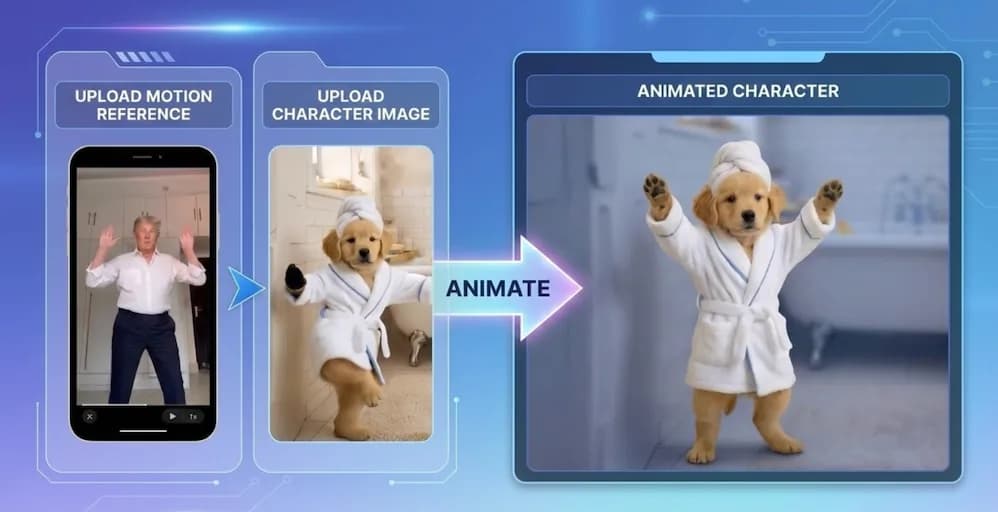
动作模仿模型可以利用你的图像重现任何动作,从任何视频中复制动作,并让你的角色做出相同的动作!
 BytePlus
Seedance 1.0 是字节跳动豆包大模型团队最新推出的视频生成基础模型。它在语义理解与指令遵循能力上取得突破,能生成运动流畅、细节丰富、风格多样且具备影视级美感的 1080P 高清视频。适合海外团队使用。
 BytePlus
Seedance 1.5 Pro 是字节跳动最新推出的音视频生成模型,能生成电影级视频、同步音频及多语言对话,并支持电影级运镜控制。
 Anthropic
Claude Haiku 4.5 是 Anthropic 最快速高效的模型,以极低成本和延迟实现媲美 Claude Sonnet 4 的前沿性能,专为实时和大规模应用场景打造。
 OpenAI
Sora 2 是 OpenAI 打造的全新一代 AI 视频创作引擎,支持从文本或图片直接生成高品质视频内容。凭借更逼真的动态效果、更稳定的物理表现,以及对风格、场景和画面比例的精细化控制,Sora 2 能帮助创作者高效实现创意构想,是内容营销、创意应用和社交媒体创作的理想选择。
 BytePlus
字节跳动的下一代模型将生成与精准编辑融为一体,具备更快的推理速度和4K输出能力,可提供适合生产的视觉效果。
 Google
谷歌 DeepMind 升级后的人工智能视频模型能够生成逼真的动态效果,延长视频时长,实现多图像参考控制,并输出同步的原生音频,同时支持1080p画质。
 Google
Nano Banana 是由谷歌发布的先进 AI 图像生成和编辑模型。它擅长通过自然语言驱动创作,能够输出具有物理一致性的超逼真图像,并支持无缝的风格转换。